AI 工具 · A1
仿真结果批处理与热阻计算
读取一批热仿真的表格导出文件,计算结到冷却液的热阻并按层分解,检查异常行,按方案与冷却条件对比,输出汇总表、图表和报告。
个人自主项目 · 2026 年 10 月制作的公开演示 · 示例数据由本站通用模型生成,不含任何雇主资料
分工方法与需求定义、结果核对由本人负责;代码由 AI 编码工具实现,并经本人审核。本案例为 2026 年 10 月制作的公开演示,使用通用模型与自建数据;工作中的同类工具因保密不公开。
Python 工具实测(示例数据)
- 导出文件
- 3
- 数据行
- 38
- 有效工况
- 36
- 标出异常
- 2
- 解析、计算与校验
- 1.4ms
数字取自仓库中的 output/run.json,即在沙箱中实际运行一次的记录;出图与报告另用 0.44 s。
处理流程
导出文件
每个设计方案一次参数化扫描,导出一个文本表格:% 开头的头注释与列名,其后为数值行。
解析
读取头注释中的方案名与说明;按列名别名识别 h、P、冷却液温度与 Tj,max,按单位换算(K → °C,kW → W)。
计算与校验
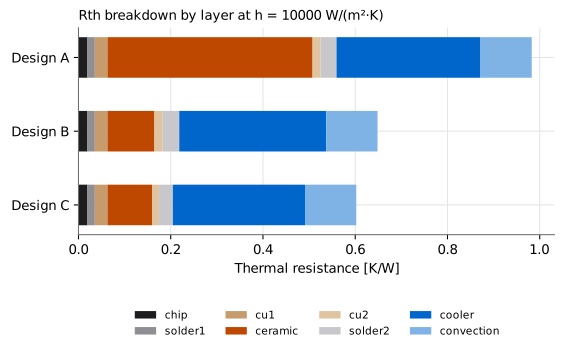
Rth = (Tj,max − T_cool) / P;有各层底面温度时按层分解。检查非数值、Rth ≤ 0、分层之和、同一 h 下随 P 单调、Rth 离群与结温上限。
对比
同一 h 下按平均 Rth 排序,给出相对最优方案的差值;按 h 的相邻档位计算 Rth 的变化率与 dRth/d(ln h)。
图表与报告
输出 summary、flagged、comparison、sensitivity 四个 CSV,三张 SVG 图和一份 Markdown 报告。
在浏览器中运行
页面内置 3 个示例导出文件(方案 A、B、C,共 38 行,其中 2 行是故意加入的异常)。点击运行后,浏览器用 TypeScript 复现与 Python 工具相同的解析、计算和校验。
本地文件只在浏览器内读取和计算,不会上传。格式见下方「限制」与 README。
示例文件design-A_al2o3-0.38mm.txtdesign-B_si3n4-0.32mm.txtdesign-C_aln-0.63mm.txt
Python 工具
tools/sim-batch-rth 下的命令行工具:batch_rth.py 只用 Python 标准库完成解析、计算、校验与对比,run_batch.py 用 matplotlib 出图并写报告;附 pytest 单元测试与固定版本的 requirements.txt。
| 导出文件 | 3 |
|---|---|
| 读取行数 | 38 |
| 有效 / 异常 / 结温提示 | 36 / 2 / 6 |
| 解析、计算与校验 | 0.0014 s |
| 出图与报告 | 0.444 s |
| 脚本总耗时(含 matplotlib 导入) | 0.794 s |
| 环境 | Python 3.13.16 · matplotlib 3.11.2 |
核心函数
parse_export:读取头注释与列名
def split_name_unit(label: str) -> tuple[str, str]:
    """'h (W/(m^2*K))' -> ('h', 'W/(m^2*K)'); nested parentheses in the unit are kept."""
    label = label.strip()
    if not label.endswith(")"):
        return label, ""
    depth = 0
    for index in range(len(label) - 1, -1, -1):
        depth += {")": 1, "(": -1}.get(label[index], 0)
        if depth == 0:
            return label[:index].strip(), label[index + 1:-1].strip()
    return label, ""


@dataclass
class Export:
    file: str
    design: str
    meta: dict[str, str]
    columns: list[tuple[str, str]]
    rows: list[tuple[int, list[str]]]  # (1-based line number, raw cells)


def parse_export(name: str, text: str) -> Export:
    """COMSOL-style table export: '% Key: value' header lines, the last '%' line names the
    columns (separated by two or more spaces or tabs), then whitespace-separated numbers."""
    meta: dict[str, str] = {}
    header_lines: list[str] = []
    rows: list[tuple[int, list[str]]] = []
    last_key = None
    for number, line in enumerate(text.splitlines(), start=1):
        if line.startswith("%"):
            content = line[1:].strip()
            header_lines.append(content)
            match = re.match(r"^([A-Za-z][\w ]*?):\s+(.*)$", content)
            if match and not re.search(r"\s{2,}\S+\s*\(", match[2]):
                last_key = match[1].strip()
                meta[last_key] = match[2].strip()
            elif last_key and content and not re.search(r"\S\s{2,}\S", content):
                meta[last_key] += " " + content
        elif line.strip():
            rows.append((number, line.split()))
    if not header_lines:
        raise ValueError("no '%' header lines")
    columns = [split_name_unit(cell) for cell in re.split(r"\t+|\s{2,}", header_lines[-1]) if cell]
    stem = Path(name).stem
    return Export(file=name, design=meta.get("Design", stem), meta=meta, columns=columns, rows=rows)
cases_from_export:计算热阻与分层热阻
def cases_from_export(export: Export) -> list[Case]:
    """Rth = (Tj_max - T_cool) / P for each row; with T_<layer>_bot probes, each layer's share is
    (T_top - T_bottom) / P, where a layer's top is the bottom of the layer above (chip top = Tj)."""
    cols = export.columns
    index = {role: _find(cols, role) for role in ("h", "power", "t_cool", "tj")}
    layer_columns = [(i, m[1]) for i, (name, _u) in enumerate(cols) if (m := LAYER_PATTERN.match(name))]
    cases = []
    for line, cells in export.rows:
        if len(cells) != len(cols):
            case = Case(export.design, export.file, line, math.nan, math.nan, math.nan, math.nan)
            case.errors.append("column_count")
            cases.append(case)
            continue
        value = lambda i: _number(cells[i])  # noqa: E731
        temperature = lambda i: _to_celsius(value(i), cols[i][1])  # noqa: E731
        case = Case(
            design=export.design, file=export.file, line=line,
            h=value(index["h"]), power=_to_watts(value(index["power"]), cols[index["power"]][1]),
            t_cool=temperature(index["t_cool"]), tj=temperature(index["tj"]),
        )
        case.rth = (case.tj - case.t_cool) / case.power if case.power else math.nan
        top = case.tj
        for column, layer in layer_columns:
            bottom = temperature(column)
            case.layers.append((layer, (top - bottom) / case.power if case.power else math.nan))
            top = bottom
        if layer_columns:
            case.layers.append(("convection", (top - case.t_cool) / case.power if case.power else math.nan))
        cases.append(case)
    return cases
check_cases:物理合理性检查
def check_cases(cases: list[Case], tj_limit: float = TJ_LIMIT_C, rth_tolerance: float = RTH_TOLERANCE) -> None:
    """Row checks first; group checks (same design and h) only among rows that passed them.
    Errors exclude a row from the comparison; warnings keep it."""
    for case in cases:
        if case.errors:
            continue
        numbers = [case.h, case.power, case.t_cool, case.tj, *(r for _n, r in case.layers)]
        if not all(math.isfinite(v) for v in numbers):
            case.errors.append("non_finite")
            continue
        if case.power <= 0 or case.h <= 0:
            case.errors.append("nonpositive_input")
            continue
        if case.rth <= 0:
            case.errors.append("nonpositive_rth")
            continue
        if case.layers and abs(sum(r for _n, r in case.layers) - case.rth) > LAYER_SUM_TOLERANCE * case.rth:
            case.errors.append("layer_sum")
    groups: dict[tuple[str, float], list[Case]] = {}
    for case in cases:
        if not case.errors:
            groups.setdefault((case.design, case.h), []).append(case)
    for group in groups.values():
        group.sort(key=lambda c: (c.power, c.line))
        for previous, current in zip(group, group[1:]):
            if current.power == previous.power:
                current.errors.append("duplicate")
            elif current.tj <= previous.tj:
                current.errors.append("power_monotonicity")
        median = _median([c.rth for c in group])
        for case in group:
            if abs(case.rth - median) > rth_tolerance * median:
                case.errors.append("rth_outlier")
    for case in cases:
        if not case.errors and case.tj > tj_limit:
            case.warnings.append("tj_limit")
compare / sensitivity:方案排序与对 h 的敏感性
def compare(cases: list[Case]) -> list[Comparison]:
    """Mean Rth per design and h over valid power steps; rank 1 = lowest Rth at that h."""
    groups: dict[tuple[str, float], list[float]] = {}
    for case in cases:
        if not case.errors:
            groups.setdefault((case.design, case.h), []).append(case.rth)
    rows = [
        Comparison(design, h, len(values), sum(values) / len(values),
                   (max(values) - min(values)) / (sum(values) / len(values)))
        for (design, h), values in sorted(groups.items(), key=lambda item: (item[0][1], item[0][0]))
    ]
    for h in sorted({row.h for row in rows}):
        same_h = sorted((row for row in rows if row.h == h), key=lambda row: (row.rth, row.design))
        for rank, row in enumerate(same_h, start=1):
            row.rank = rank
            row.delta_vs_best = row.rth / same_h[0].rth - 1
    return sorted(rows, key=lambda row: (row.design, row.h))


def sensitivity(rows: list[Comparison]) -> list[dict]:
    """Change in Rth between successive h levels, and dRth/d(ln h) in K/W per e-fold of h."""
    result = []
    for design in sorted({row.design for row in rows}):
        series = sorted((row for row in rows if row.design == design), key=lambda row: row.h)
        for low, high in zip(series, series[1:]):
            result.append({
                "design": design, "h_from": low.h, "h_to": high.h,
                "rth_from": low.rth, "rth_to": high.rth,
                "change": high.rth / low.rth - 1,
                "slope": (high.rth - low.rth) / math.log(high.h / low.h),
            })
    return result
验证
- 网页与 Python 一致:单元测试用本页的 TypeScript 实现处理同一批示例文件,要求生成的 summary、flagged、comparison、sensitivity 四个 CSV 与仓库中 Python 的输出逐字节相同。
- 示例数据可复现:model:lab:verify 用本站 S1 的解析热阻网络重新生成 3 个导出文件,要求与仓库中的文件逐字节相同。
- Python 单元测试覆盖单位换算、嵌套括号的单位、每一类异常、无法读取的文件跳过,以及下面两项手算。
手算核对(方案 A,h = 10000 W/(m²·K),P = 90 W)
- 对流热阻
R = 1 / (h · A) = 1 / (10000 × 0.030²) = 0.1111 K/W工具输出:0.111111 K/W- 陶瓷层(45° 扩散)
R = t / (k · a_in · a_out) = 0.38 mm / (24 × 5.6 mm × 6.36 mm) = 0.4446 K/W工具输出:0.444557 K/W
限制
- 示例数据来自本站 S1 的解析热阻网络(恒定物性、线性),因此 Rth 不随功率变化;真实 COMSOL 结果若含温度相关物性,Rth 会随功率变化,离群容差(默认 ±5 %)需按实际调整。
- 文件仿照 COMSOL 表格导出的文本格式,但不是 COMSOL 实际导出;实际格式随版本与导出设置(分隔符、列名、单位、是否包含参数列)而不同,未识别的列名需在别名表中补充。
- 分层热阻需要导出各层底面的探针温度(T_<层>_bot 列);只有 Tj,max 时只计算总热阻。只处理稳态标量结果,不处理瞬态 Zth 曲线和场数据。
- 不涉及任何雇主数据;工作中的同类工具因保密不公开。